3 juli 2023 · Ivo Hendriks
Op naar een API Referentiearchitectuur (ARA): Timmeren we nog aan de juiste weg?
Naar aanleiding van de eerste ervaringen met deze standaarden is een aantal vraagstukken ontstaan dat raakt aan het fundament onder alle API-standaarden voor gemeenten. Eind vorig jaar schreven we over de route naar een API Referentiearchitectuur (ARA) die deze vraagstukken moet beantwoorden. En aan de hand van de ‘ARA Birdseye view’ verzamelden we tijdens een eerdere bijeenkomst argumenten om wel of niet te ‘knippen’ in gegevenssets die het fundament vormen onder de gemeentelijke informatievoorziening.
Wat moet een standaard nu eigenlijk standaardiseren?
Eind mei kwamen we opnieuw samen met een groep gemeenten en marktpartijen. Dit keer om aan de hand van de standaard voor klantinteracties die we ontwikkelen twee thema’s te bespreken die raken aan de vraag of we (nog) de juiste standaarden ontwikkelen:
- Welke API-inrichtingspatronen denken gemeenten en hun leveranciers op de korte en lange termijn toe te passen, en in hoeverre zou een standaard die moeten ondersteunen?
- Moet een API-ontwerp implementerende partijen maximale toepassingsvrijheid gunnen door eenvoudigweg een CRUD-operaties op een gegevensset mogelijk te maken, of zien we liever standaarden die specifieke ‘businesshandelingen’ ondersteunen?
<p>ARA Bird's-eye view met illustratie van in deze blog besproken thema's</p>
API-inrichtingspatronen
‘Inrichtingspatroon’ is een wat abstract begrip. Hiermee doelen we op verschillende wijzen waarop combinaties van applicaties, componenten en API-(standaarden) kunnen worden ingezet om bijvoorbeeld een compleet overzicht van alle zaken of klanten te krijgen, ook al zijn de daarvoor benodigde gegevens opgeslagen in verschillende ‘bronsystemen’. We kijken hier dus naar oplossingen voor het bevragen van gegevens. Hoewel ongetwijfeld aanvullende varianten te bedenken zijn waarin kenmerken van deze varianten op andere manieren worden gegroepeerd, legden we de volgende vier patronen voor:
- Aggregatie: API’s die dezelfde standaarden volgen, maar in verschillende bronsystemen zijn geïmplementeerd, worden door middel van een aggregatie-API in één keer bevraagd. Deze voegt het resultaat van bevragingen van de verschillende bronsystemen samen en levert die door aan het systeem van de aanvrager. Dit patroon waarborgt levering van actuele gegevens, maar het bevragen van meerdere bronsystemen kan leiden tot veel netwerkverkeer en dus een lage performance.
- Cache: dit patroon lijkt op het bovenstaande, maar nu wordt om het netwerkverkeer te beperken een cache bijgehouden waarin een kopie van gegevens uit de verschillende bronsystemen beschikbaar is. Hiertoe worden gegevens uit bronsystemen gerepliceerd. Kenmerk van een cache is dat de kopiegegevens een beperkte levensduur hebben. Ze worden ofwel na een vastgestelde periode ofwel naar aanleiding van een signaal over mutatie bij ‘de bron’ vervangen door een ‘verse’ kopie. Bij dit patroon worden dus actualiteitsgaranties ingeruild voor een betere performance.
- Magazijn: dit patroon lijkt op een cache, maar de kopiegegevens hebben nu een meer permanent karakter. Mogelijk geldt het magazijn zelfs als duurzame ‘afslag’ waarin gegevens uit bronsystemen ook na vervanging van die systemen beschikbaar blijven. Bovendien kunnen gegevens in een magazijn getransformeerd worden, bijvoorbeeld om ze aan een bepaalde standaard te laten voldoen, en kan hierin functionaliteit gerealiseerd worden die bronsystemen niet leveren, bijvoorbeeld voor het bevragen van historische gegevens.
- Register: in tegenstelling tot de twee laatste patronen ontstaan in dit patroon geen kopieën van gegevens. Het patroon gaat er in plaats daarvan vanuit dat samenhangende gegevenssets zijn opgeslagen in registers. Dit zijn componenten die alle functionaliteit leveren om daarbinnen opgeslagen gegevens te kunnen bijhouden, deze (duurzaam) te bewaren en aan afnemers beschikbaar te stellen. Afnemersystemen die in een register beschikbare gegevens gebruiken of muteren, gebruiken bij deze handelingen de door het register aangeboden API’s.
Het registerpatroon wordt algemeen gezien als het ‘einddoel’ waarnaar we toewerken. Dit stelt gemeenten immers in staat door middel van standaardisatie en (mogelijk) het zelf beheren van hun ‘systems of record’ meer controle te krijgen over hun informatievoorziening, terwijl diezelfde standaardisatie ervoor moet zorgen dat het ontwikkelen van ‘systems of differentiation’ en ‘systems of innovation’ (terminologie ontleend aan Gartners pace layered architecture) eenvoudiger wordt. Dus maar 'gewoon' ontwerpen voor registers? Daartegen zijn tenminste twee ‘maren’ in te brengen.
De eerste heeft te maken met het karakter van de gegevens waarnaar we kijken. Wil je bijvoorbeeld organisatiebreed te gebruiken contactgegevens van inwoners bijhouden, dan ligt het niet voor de hand die in de vorm van verschillende – mogelijk conflicterende – gegevenssets bij te houden. Een ‘single source of truth’ in de vorm van een register lijkt hier het aangewezen patroon. Maar aan de andere kant is het de vraag of je bijvoorbeeld zaakgegevens, die op hoofdlijnen van de uitvoering van een proces beschrijven, volledig wil ‘losknippen’ van gegevens die het verloop van dat proces in meer (domeinspecifiek) detail beschrijven. Het wordt op die manier immers lastig om consistentie tussen verschillende ‘bronnen’ van procesgegevens te garanderen, en onmogelijk om vanuit één component een overzicht van het procesverloop te krijgen. Misschien ligt in dit geval daarom een magazijnpatroon meer voor de hand.
Een tweede ‘maar’ heeft te maken met transitie. Een informatievoorziening gebouwd op een fundament van registers mag dan het doel zijn, voorlopig hebben we te maken met ‘traditionele’ applicaties die niet allemaal tegelijkertijd vervangen kunnen worden, terwijl we in die applicaties opgeslagen gegevens daarbuiten wél willen kunnen hergebruiken. Als het overhevelen van die gegevens naar een register (technisch en/of financieel) te ingrijpend is, kan voor het benutten van die hergebruikwaarde een aggregatie- of of cachepatroon worden ingezet.
Bij het lezen van het bovenstaande zou je je kunnen afvragen wat de keuze voor een inrichtingspatroon te maken heeft met standaardisatie. Het woord ‘inrichting’ impliceert inderdaad dat we het hebben over toepassing van standaarden, en niet de vorm of kenmerken van die standaard zelf. Dit is ten dele waar. De kern van zo’n standaard – de manier waarop we een gegevensset modelleren of de samenstelling die afnemers verwachten – verandert naar aanleiding van het gekozen inrichtingspatroon niet. Aan de andere kant wil je bij een aggregatie-inrichting misschien weten uit welk bronsysteem een set gegevens afkomstig is, en vereisen cache en magazijn replicatie- en mogelijk andere aanvullende functionaliteit. Willen we die – als we deze patronen überhaupt willen toepassen – ook standaardiseren?
API-ontwerp
Een tweede besproken thema betrof de uitgangspunten of 'oriëntatie’ die we volgen bij het ontwerpen van API-standaarden. In de 'Bird’s-eye view’ beschreven we daarvoor twee mogelijkheden. ‘gegevensgedreven’ en ‘handelingsgedreven’. Maar wat betekenen die begrippen nu eigenlijk?
- Gegevensgedreven standaarden volgen heel nauw het informatiemodel waarop ze gebaseerd zijn. Daarin beschreven ‘objecttypes’ (‘klantcontact’, ‘betrokkene’, ‘zaaktype’) worden min of meer één op één omgezet naar ‘API-resources’. Deze resources kunnen door middel van ‘create’, ‘read’, ‘update’ en ‘delete’-handelingen worden gemaakt, bevraagd, bijgewerkt en verwijderd. Dit maakt het mogelijk om steeds kleine groepjes gegevens die mogelijkerwijs onderdeel zijn van een grotere samenhangende gegevensset weg te schrijven. Bijvoorbeeld: een KCC-medewerker voert een telefoongesprek met een klant over een opleiding van de gemeente waar deze zich voor wil inschrijven. Een gegevensgedreven standaard maakt het voor de medewerker mogelijk om tijdens het gesprek ingewonnen gegevens ‘druppelsgewijs’ vast te leggen. Eerst naam- en adresgegevens, vervolgens een aanvraag voor cursusmateriaal en ten slotte de inschrijving voor een specifieke cursusdag.
- Handelingsgedreven standaarden zijn weliswaar gebaseerd op een informatiemodel, maar naar aanleiding daarvan zijn nu handelingen gedefinieerd. Deze sluiten nauw aan bij ‘businesshandelingen’ die door mensen of geautomatiseerde systemen worden uitgevoerd. Hetzelfde telefoongesprek dat hierboven als voorbeeld heeft gediend zou nu bijvoorbeeld resulteren in het in één keer wegschrijven van een cursusinschrijving inclusief naam- en adresgegevens van de cursist en een taak om haar het benodigde cursusmateriaal op te sturen.
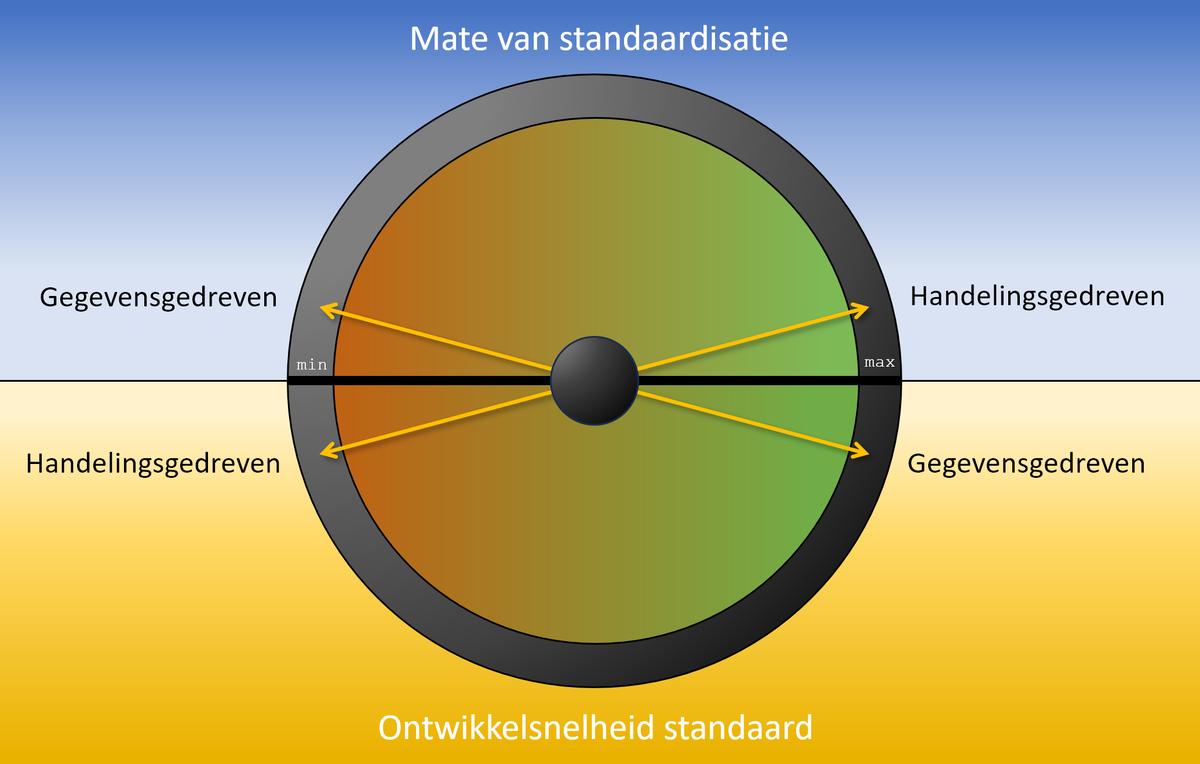
Gegevensgedreven standaarden bieden veel vrijheid. Afnemers kunnen (binnen de grenzen van eventuele toegangsbeperkingen) zelf bepalen voor welk doel ze een zelf samen te stellen set gegevens willen gebruiken. Het is ook eenvoudiger standaarden te ontwikkelen die volledig aansluiten bij de REST-architectuur als de gegevensgedreven oriëntatie gevolgd wordt. Ontwikkelsnelheid is een derde factor. Die is hoger dan bij handelingsgedreven standaarden omdat de tijdrovende klus van het naar aanleiding van gesprekken met gebruikers achterhalen van handelingen en de daarbij benodigde gegevens achterwege kan blijven. Hierbij moet wel worden aangetekend dat deze analyse nu zal moeten worden uitgevoerd door partijen die de standaard willen gaan gebruiken.
Het uitvoeren van een handelingenanalyse en het verwerken van het resultaat daarvan in een handelingsgedreven standaard lijkt de moeite waard. Hierdoor wordt immers een belangrijk deel van de mogelijke interpretatieverschillen weggenomen over welke gegevens bij een bepaalde handeling in welke volgorde en samenhang worden vastgelegd. Interoperabiliteit en eenvoudige vervanging van informatiesystemen zijn hiermee zeer gediend.
Een ander voordeel van handelingsgedreven standaarden is dat ze de transactionele integriteit van gegevenssets ondersteunen. Stel nu dat aan het eind van het telefoongesprek over de cursusinschrijving blijkt dat die alleen voor stadspashouders bedoeld is, terwijl de inwoner die niet heeft? In het gegevensgedreven voorbeeld moet nu de aanvraag voor cursusmateriaal worden geannuleerd, terwijl geregistreerde naam- en adresgegevens moeten worden verwijderd. Als dat niet lukt houden we ‘weesgegevens’ over. In het handelingsgedreven voorbeeld kan het bezit van een stadspas worden opgenomen als voorwaarde voor registratie van een cursusinschrijving. Wordt daaraan niet voldaan, dan worden dus in het geheel geen gegevens geregistreerd. En last but not least: handelingen kunnen gebruikt als basis voor betekenisvolle notificaties die nodig zijn voor gebeurtenisgedreven werken.
<p>Communicerende vaten: het ontwikkelen van gegevensgedreven standaarden kan (relatief) snel, maar de mate van standaardisatie is (eveneens relatief) laag. Willen we die met handelingsgedreven standaarden verhogen, dan gaat dat evenredig ten koste van de ontwikkelsnelheid</p>
Heet hangijzer bij het ontwikkelen van handelingsgedreven standaarden zijn de eisen die deze stellen aan het ontwikkelproces. Een goede standaard móet handelingen die gebruikers (vaak) uitvoeren ondersteunen. Waar gegevensgedreven standaarden afnemers de vrijheid bieden aan alle mogelijke handelingen invulling te geven, ontbreekt deze mogelijkheid bij handelingsgedreven standaarden. Een in de standaard niet gedefinieerde handeling kan dus (zonder de standaard te passeren) niet worden uitgevoerd.
Goede handelingsgedreven standaarden nauwe samenwerking tussen analisten, standaardontwikkelaars en vertegenwoordigers uit ‘de business’ waarop de standaard zich richt. Bovendien verwachten we dat implementatie van onvolmaakte standaardversies de enige manier is om écht snel inzicht te krijgen in ontbrekende handelingen. Hiervoor zijn nieuwe samenwerkingsvormen nodig. Kunnen we dit wel? Zijn we hiertoe bereid? Of zijn inspanning en risico's te groot?
Aan de andere kant: “als we blijven doen wat we deden, zullen we blijven krijgen wat we kregen.” Onze eerste blog sloten we af met dit citaat van Stephen Covey. Wat betekent dit voor ARA en de standaard voor Klantinteracties? Voor die laatste werken we op dit moment concepten in zowel een meer gegevens- als handelingsgedreven richting uit. Naar aanleiding van deze voorbeelden zetten we na de zomer het gesprek over de in deze blog besproken thema’s met ARA-gemeenten en marktpartijen voort. Daaruit blijkt hopelijk dat we nog aan de juiste weg timmeren :).
Blijf op de hoogte!
Wil je op de hoogte blijven houd dan de blogs op commonground.nl in de gaten. Op LinkedIn wordt de blog ‘gepusht’. Stuur Mascha en of Ivo een connectieverzoek om regelmatig updates over dit onderwerp te ontvangen.
Auteurs: Ivo Hendriks (Architect Kenniscentrum Architectuur, Ivo.Hendriks@vng.nl) en Mascha Kranse (Coördinator Kenniscentrum Architectuur, Mascha.Kranse@vng.nl).